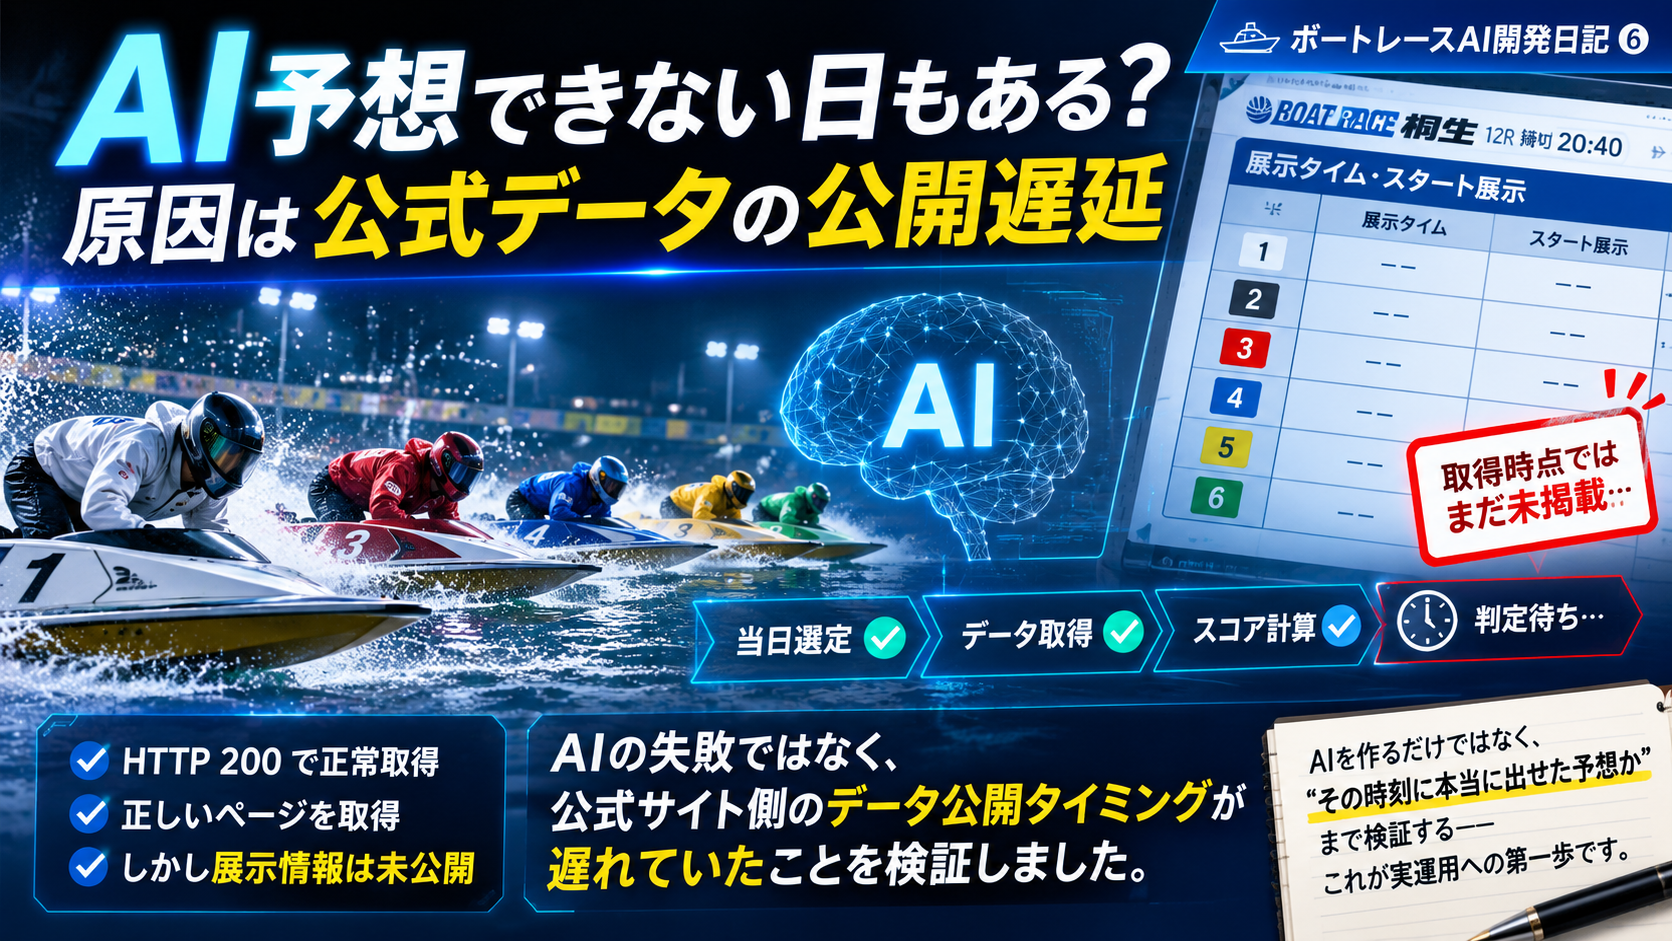
ボートレースAIを自動運用していると、AIの予想精度とは別の問題が発生することがある。
8月26日の桐生12Rでは、システムは正常に起動し、公式ページへのHTTPアクセスにも成功した。
しかし、正式Forward判定に必要な展示情報を取得するbeforeinfoが、取得時点ではまだ公式ページに掲載されていなかった。
今回は、この原因を保存HTMLと前日のデータを使って検証した。
桐生12RでAI予想が止まった
8月26日は桐生12Rを対象として自然起動した。
自然起動は20:30 JST。
executorは1回起動し、正式Forward処理は20:32:58 JSTに開始した。
racelistとbeforeinfoへのHTTPアクセスはいずれも成功。
しかしbeforeinfoでは、
- 展示タイム6艇すべて空欄
- スタート展示すべて空欄
だった。
必要情報が揃っていなかったため、正式なPURCHASE/SKIP判定は作成しなかった。
取得失敗ではなく、まだ公開されていなかった
最初に考えられる原因として、
- URLの間違い
- リクエスト条件の問題
- HTTP通信失敗
- HTML解析処理の問題
- 取得時刻が早すぎた
- 公式サイト側の公開遅延
を切り分けた。
取得URLとパラメータは正常。
HTTPステータスも200。
さらに保存HTMLを確認すると、桐生12R・締切20:40の正しいページが保存されていた。
しかし、そのHTMLにも展示タイムとスタート展示の値が存在しなかった。
したがって、
「掲載されている値をシステムが取り損ねた」
のではなく、
「取得時点では公式ページにもまだ値が掲載されていなかった」
と判断できる状態だった。
前日の桐生12Rと比べてみた
8月25日の桐生12Rと比較した。
8月25日は正式Forward処理開始の約51.821秒前の取得時点で、6艇分のbeforeinfoがすでに公開されており、正常に取得できていた。
8月26日は正式Forward処理開始の約51.374秒前。
差は約0.45秒しかない。
しかし、
- 8月25日:公開済み
- 8月26日:未公開
となった。
このため現時点では、prep処理が恒常的に早すぎることが原因とは判断していない。
8月26日は公式サイト側の公開タイミングが前日より遅れた可能性が高いと判断した。
後から公開されたデータは使わない
その後に展示情報が公開されたとしても、今回のForward Testでは再判定しない。
理由は、
「実際にその時刻に利用できた情報だけで予想する」
ことをForward Testの条件としているため。
判定時刻を過ぎてから情報を追加して予想を作れば、実運用時に出せた予想ではなくなる。
そのため8月26日は、
「後から見れば予想できたレース」
ではなく、
「正式Forward時点では必要情報が揃わず、判定を成立させられなかったレース」
として記録する。
Forward Testでは「予想できたか」も評価する
バックテストでは、必要データが揃った状態でAIを評価できる。
しかし本番運用では、
- 自動処理が予定時刻に起動するか
- 必要データが取得できるか
- スコア計算が間に合うか
- 正式判定window内に判定できるか
- 公式データがその時刻までに公開されるか
まで含めて確認する必要がある。
当たるかどうかだけでなく、その時刻に本当に出せた予想かどうかも検証しています。
以前には、データ取得とスコア計算まで完了しても、最終判定が時間を超過し、
MISSED_PRECHECK_WINDOW
として判定を保存しなかったケースもある。
後から計算し直せばAIの結果を出すことはできる。
しかし、それではForward Testではない。
今回の最終判定
8月26日の桐生12Rについては、
FORMAL_FORWARD_BEFOREINFO_PUBLICATION_DELAY_CONFIRMED
と記録した。
意味は、
「正式Forward判定に必要なbeforeinfoが、その時点ではまだ公式サイトに公開されていなかったことを確認した」
というもの。
AIの故障、通信障害、HTML解析失敗とは区別している。
1回の遅延だけではシステムを変更しない
今回の1事例だけを理由に、
- Stage 5.8の自動選定ロジック
- prep設計
- 正式なForward判定window
- AI判定条件
は変更しない。
前日はほぼ同じ条件で正常取得できているため、1件だけに合わせて時刻設計を変更しない。
今後も同じ条件でForward運用を続け、公開遅延がどの程度発生するかを記録する。
事例が蓄積した段階で、
- beforeinfo公開時刻のばらつき
- Forward成立率
- 欠測率
などを確認する。
AIを作るだけでは本番運用にならない
今回特に重要だったのは、AIが予想できなかったことそのものではない。
保存HTMLを残していたことで、
「システムがデータを取得できなかった」のか、
「公式データそのものがまだ存在しなかった」のか
を後から切り分けることができた。
さらに、後から公開された情報で都合よく判定を作り直さず、欠測として正式に記録できた。
予想モデルの精度だけではなく、データ取得から判定まで含めて実際に動くかを見る。
こうした検証を続けながら、AI予想から実運用できる予想システムへ少しずつ近づけていく。
前回は、レース選びからAI予想までを自動でつないだところまで紹介しました。
次回は、SHADOW運用を3回連続で正常完了できたところまでをまとめています。
コメント